
Transformer it self
![[Pasted image 20240414153828.png]]
Transformer 基于现有的序列-序列模型,使用 「encoder-decoder」 架构。在 encoder-decoder 架构中,编码器(encoder)将输入序列 转换为一个连续的表达 ,然后解码器再基于该表达生成输出序列 。
1.1.1 Encoder
由 6 层组成,每一层包括两个子层:「第一层」 是 multi-head self-attention 层, 「第二层」 是一个简单的全连接前馈网络。在每个子层后,都接了一个 「残差连接以及归一化」 ,即每个子层的输出为 . 为了方便残差连接,模型中的所有子层,包括 embedding 层(初始词嵌入),输出向量维度均为.
1.1.2 Decoder
同样由 6 层组成,每一层包括三个子层:「第一层」 是 masked multi-head self-attention 层,注意其输入仅包含 「当前位置之前的词语信息」,这样设计的目的是解码器是按顺序解码的,其当前输出只能基于已输出的部分。「第二层」 是 multi-head self-attention 层,其输入包含编码器的输出信息(矩阵 K 和矩阵 V ),「第三层」 是全连接前馈网络。每个子层后同样加入了 「残差连接和归一化」。下图给出了编码器和解码器的内部结构,注意前馈神经网络对于序列每个位置的独立性。
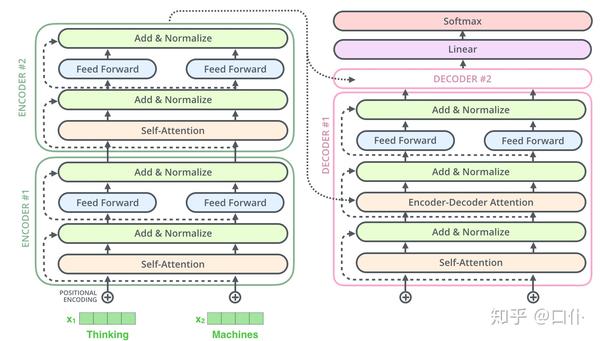
1.1.3 Linear and Softmax Layer
解码器的输出被输入到一个线性层中,转化为一个超长向量(词典长度),再输入到 softmax 层中转化为概率,最后运用适当策略(如贪婪搜索或束搜索)选择输出的词语,注意 「一次只输出一个词语」 。已输出的序列会作为解码器的输入。下图给出了贪婪搜索策略下的运行流程。
![[Pasted image 20240414165245.png]]
[[Pasted image 20240414165245.png]]